
08.10.2026 08:28:53

08.10.2026 08:22:49
В C# Dev Kit 11.0 для .NET 11 Microsoft переписала серверную часть: шесть взаимосвязанных процессов объединены в один нативный (Native AOT) сервер, добавлено кэширование проектов. Решение Orleans (155 проектов) открывается за 2,3 с, Aspire (407 проектов) — за 3,0 с, тогда как раньше уходило до 50,3 и 84,1 с соответственно.
Потребление памяти серверной частью упало на 81–85% (у Aspire с 2072 МБ до 316 МБ), а пересборка без изменений занимает 0,88 с вместо 34,4 с. Чтобы попробовать, достаточно переключиться на предрелизную версию расширения («Switch to Pre-Release Version»).
08.10.2026 08:22:46
Anthropic выпустила Claude Haiku 5.5 — самую младшую и быструю модель линейки для больших объёмов недорогих задач: сводок, классификации, запросов к базам данных и сжатия контекста. По сравнению с Haiku 4.5 эксплуатация в среднем подешевела на 75%.
Для запросов до 100 000 токенов цена составляет $0,10 за миллион входных и $0,50 за миллион выходных токенов, чтение из кеша — $0,01. Для Sonnet 5.5 чтение из кеша стало вдвое дешевле, из-за чего большинство агентских задач обходится примерно на 20% дешевле. Модель доступна на платформе Claude, в AWS, Google Cloud и Azure.
08.10.2026 08:22:26
Автор сравнил промпты на русском и английском для Claude Code: модели Haiku 4.5 и Sonnet 5.5, пять задач на Python, каждая на каждом языке дважды — всего 40 прогонов, результат проверялся скрытыми тестами.
Русский промпт в среднем длиннее всего на 12 токенов. По успешности итоги противоречивы: Haiku решил 7 из 10 задач на русском и 8 из 10 на английском, Sonnet — 10 из 10 и 9 из 10. Вывод: пишите на том языке, на котором задача формулируется точнее, а реальную экономию дают MCP-серверы и размер контекста.

07.10.2026 10:14:46
16-летний подросток чуть не погиб у скального участка под названием Widowmaker Arete («Гребень „Вдоводел“») на горе Краун (Crown Mountain) в Британской Колумбии. Он попал туда, следуя маршруту, который предложил ему ИИ Claude.
07.10.2026 09:29:34
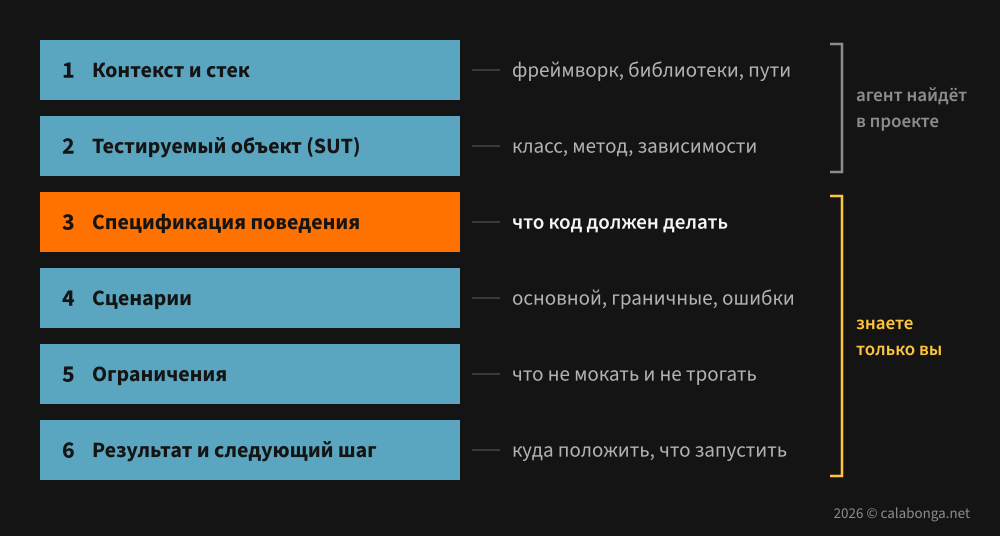
Попросить ИИ-агента написать тесты — дело одной строки. Получить тесты, которые действительно что-то проверяют, гораздо сложнее. В этой статье разберём, как сформулировать задачу, какие инструкции один раз положить в репозиторий и как выстроить процесс, чтобы агент писал полезные unit-тесты, а не просто зелёные. Примеры будут для Claude Code на стеке xUnit + Moq + AutoFixture. При этом всё сказанное применимо к любому агенту: GitHub Copilot, Cursor, Codex и другим. Меняются только имена файлов и команды.

07.10.2026 00:36:30
Память Claude Code хранится только на одной машине, и при работе с двух компьютеров агент «забывает» всё накопленное. Автор решил это приприватным git-репозиторием и двумя bash-скриптами по ~20 строк, подключёнными через хуки SessionStart и Stop.
Чтобы не загружать в контекст все 114 заметок, используется таблица маршрутизации. Агент читает и пишет обычную папку с markdown-файлами, которую удобно просматривать в Obsidian.
07.10.2026 00:36:28
Google приостановила программу вознаграждений за уязвимости в open source (Open Source Software Vulnerability Rewards Program) из-за потока отчётов, сгенерированных ИИ, с «техническими галлюцинациями».
Новые сообщения не рассматриваются с 1 октября, возобновление программы ожидается не раньше первого квартала 2027 года.

07.10.2026 00:36:26
Автор поставил эксперимент: Qwen3.8-27B на двух RTX 5090 должна была найти причину реального инцидента — утечки соединений в сервисе из-за редкой гонки в httpcore5 5.3.6. Локальная модель воспроизвела проблему в 2 из 5 запусков — результат на уровне Opus 5.5, только за 2 часа вместо 20 минут.
Вывод: для критичных инцидентов лучше облачные модели, а локальные подходят для ночных расследований. При этом модель, которая честно пишет «не смог доказать», надёжнее той, что выдаёт уверенные, но неверные отчёты.
07.10.2026 00:36:24
Исследователь Sayed Anas Mohiuddin показал, что ИИ-агенты по умолчанию доверяют друг другу: достаточно скомпрометировать одного, и вредоносные команды распространяются дальше через MCP («переключение протокола»).
За пять месяцев схожие уязвимости подтвердили Google и ещё четыре организации, включая критическую у Google с оценкой 8 из 10. Разработчики при развёртывании ИИ-инфраструктуры часто игнорируют принцип zero trust.