Мысли в голове
И остаются в голове.
Всего за многие года
Их накопилось целых две.
Одна другой они подстать.
И в каждой бездна благодати.
То размышляешь, где достать.
То думаешь, на что потратить.
09.10.2026 04:55:37
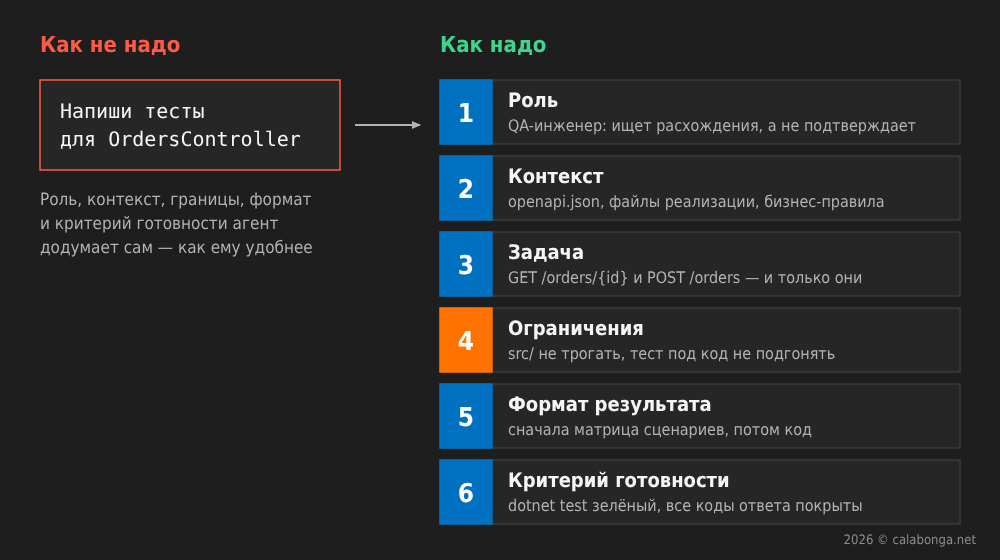
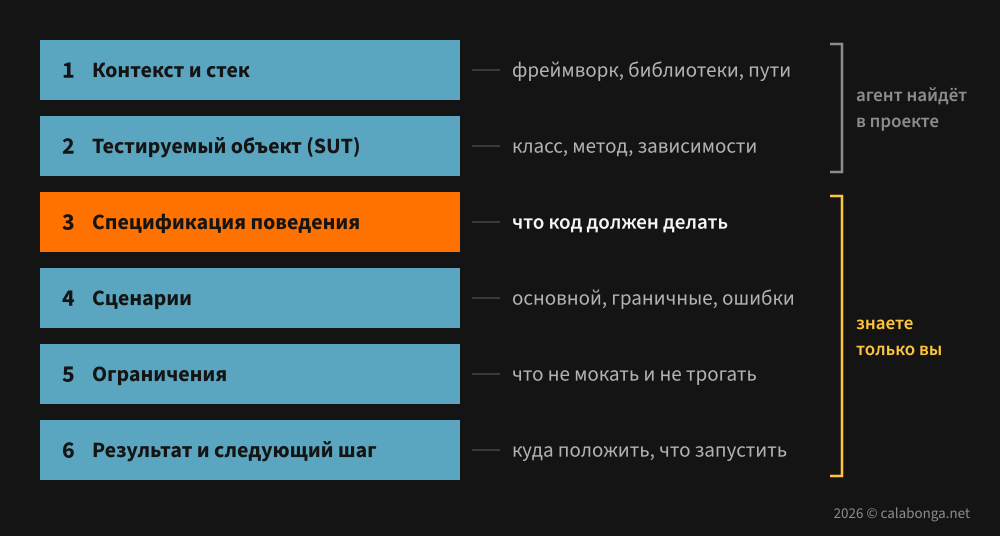
Тесты для API — это, пожалуй, одна из тех задач, которые разработчики любят меньше всего. Не потому, что сложно, а потому, что однообразно: подготовить данные, отправить запрос, проверить код ответа, проверить тело ответа, повторить для невалидных данных, для неавторизованного пользователя, для несуществующей записи… И так для каждой конечной точки (endpoint). Неудивительно, что именно эту работу хочется отдать ИИ-агенту (AI agent) в первую очередь.

08.10.2026 08:28:53

08.10.2026 08:22:49
В C# Dev Kit 11.0 для .NET 11 Microsoft переписала серверную часть: шесть взаимосвязанных процессов объединены в один нативный (Native AOT) сервер, добавлено кэширование проектов. Решение Orleans (155 проектов) открывается за 2,3 с, Aspire (407 проектов) — за 3,0 с, тогда как раньше уходило до 50,3 и 84,1 с соответственно.
Потребление памяти серверной частью упало на 81–85% (у Aspire с 2072 МБ до 316 МБ), а пересборка без изменений занимает 0,88 с вместо 34,4 с. Чтобы попробовать, достаточно переключиться на предрелизную версию расширения («Switch to Pre-Release Version»).
08.10.2026 08:22:46
Anthropic выпустила Claude Haiku 5.5 — самую младшую и быструю модель линейки для больших объёмов недорогих задач: сводок, классификации, запросов к базам данных и сжатия контекста. По сравнению с Haiku 4.5 эксплуатация в среднем подешевела на 75%.
Для запросов до 100 000 токенов цена составляет $0,10 за миллион входных и $0,50 за миллион выходных токенов, чтение из кеша — $0,01. Для Sonnet 5.5 чтение из кеша стало вдвое дешевле, из-за чего большинство агентских задач обходится примерно на 20% дешевле. Модель доступна на платформе Claude, в AWS, Google Cloud и Azure.
08.10.2026 08:22:26
Автор сравнил промпты на русском и английском для Claude Code: модели Haiku 4.5 и Sonnet 5.5, пять задач на Python, каждая на каждом языке дважды — всего 40 прогонов, результат проверялся скрытыми тестами.
Русский промпт в среднем длиннее всего на 12 токенов. По успешности итоги противоречивы: Haiku решил 7 из 10 задач на русском и 8 из 10 на английском, Sonnet — 10 из 10 и 9 из 10. Вывод: пишите на том языке, на котором задача формулируется точнее, а реальную экономию дают MCP-серверы и размер контекста.