Промпт-инжиниринг для Unit-тестов — как настроить ИИ-агента
Попросить ИИ-агента написать тесты — дело одной строки. Получить тесты, которые действительно что-то проверяют, гораздо сложнее. В этой статье разберём, как сформулировать задачу, какие инструкции один раз положить в репозиторий и как выстроить процесс, чтобы агент писал полезные unit-тесты, а не просто зелёные. Примеры будут для Claude Code на стеке xUnit + Moq + AutoFixture. При этом всё сказанное применимо к любому агенту: GitHub Copilot, Cursor, Codex и другим. Меняются только имена файлов и команды.
Почему «напиши тесты» не работает
Давайте начнём с эксперимента. Возьмём простой сервис оформления заказа. Он отклоняет пустой заказ, начисляет скидку в зависимости от суммы и сохраняет заказ в базу данных. В примере используются две мои сборки:
- Calabonga.Results — реализация паттерна Result (Result Pattern). Сервис возвращает
Operation<T, TError>: у результата есть признак успехаOk, значениеResultи ошибкаError, а создаётся он черезOperation.Result(...)илиOperation.Error(...). - Calabonga.UnitOfWork — реализация паттерна «Единица работы» (Unit of Work) для EntityFrameworkCore. Репозиторий берётся через
GetRepository<T>(), изменения сохраняются черезSaveChangesAsync(). Важная деталь:SaveChangesAsync()не выбрасывает исключение при ошибке, а записывает его вIUnitOfWork.Result, поэтому успех сохранения проверяется черезResult.Ok.
using Calabonga.OperationResults;
using Calabonga.UnitOfWork;

public sealed class OrderService(IUnitOfWork unitOfWork)
{
    public async Task<Operation<Order, string>> PlaceOrderAsync(Order order, CancellationToken cancellationToken)
    {
        if (order.Items.Count == 0)
        {
            return Operation.Error("Пустой заказ");
        }

        var discountRate = order.Total switch
        {
            >= 50_000m => 0.10m,
            >= 10_000m => 0.05m,
            _ => 0m
        };

        order.ApplyDiscount(order.Total * discountRate);

        await unitOfWork.GetRepository<Order>().InsertAsync(order, cancellationToken);
        await unitOfWork.SaveChangesAsync();

        if (!unitOfWork.Result.Ok)
        {
            return Operation.Error("Не удалось сохранить заказ");
        }

        return Operation.Result(order);
    }
}
Теперь откроем агента и напишем ему «Напиши тесты для OrderService». Через полминуты у нас будет десяток зелёных тестов, и среди них почти наверняка окажется что-то такое:
[Fact]
public async Task PlaceOrderAsync_Test()
{
    var repository = new Mock<IRepository<Order>>();
    var unitOfWork = new Mock<IUnitOfWork>();
    unitOfWork.Setup(x => x.GetRepository<Order>(It.IsAny<bool>())).Returns(repository.Object);
    unitOfWork.Setup(x => x.Result).Returns(new SaveChangesResult());
    var sut = new OrderService(unitOfWork.Object);
    var order = new Order([new OrderItem("SKU-1", price: 12_000m, quantity: 1)]);

    var result = await sut.PlaceOrderAsync(order, CancellationToken.None);

    var expected = order.Total >= 10_000m ? order.Total * 0.05m : 0m;
    Assert.NotNull(result);
    Assert.Equal(expected, result.Result.Discount);
    unitOfWork.Verify(x => x.SaveChangesAsync(), Times.Once);
}
Посмотрите внимательно. Ожидаемое значение здесь вычисляется той же формулой, что и в коде. Если в сервисе ошибка, она один в один повторяется в тесте, и тест остаётся зелёным. Assert.NotNull не проверяет вообще ничего: Operation<T, TError> — структура, и null она не бывает никогда. Признак успеха Ok при этом не проверен. Имя теста ничего не говорит о проверяемом поведении. Граничные значения 10 000 и 50 000 не проверяются вовсе. Ветка с ошибкой сохранения не проверена: агент настроил успешный SaveChangesResult просто для того, чтобы тест не упал. И ещё четыре строки шаблонного кода настройки моков будут повторяться в каждом тесте.
Это не значит, что модель «глупая». Мы дали ей код и не дали ничего, кроме кода. Агент честно прочитал реализацию и написал тесты, которые эту реализацию повторяют. О том, каким должно быть поведение, он не знает: мы ему этого не сказали. Отсюда главный тезис статьи: качество сгенерированных тестов определяется постановкой задачи, а не моделью. Промпт-инжиниринг (prompt engineering) в этом контексте — способ передать агенту то, что знаем мы, и не знает он.
Каким должен быть хороший unit-тест
Прежде чем что-то требовать от агента, договоримся, что именно мы требуем. Список ниже — это не теория ради теории. Почти каждый пункт потом перейдёт в промпт или в файл инструкций.
- Структура Arrange / Act / Assert (AAA). Подготовка, действие, проверка. Три блока, визуально разделённые. Тест читается сверху вниз без усилий.
- Один тест — одно поведение. Не «тест метода», а «тест сценария»: пустой заказ отклоняется; заказ на 10 000 получает скидку 5%. Если тест упал, по его имени уже понятно, что сломалось.
- Говорящее имя. Формат
Метод_Условие_ОжидаемыйРезультат:PlaceOrderAsync_EmptyOrder_ReturnsFailure. Можно спорить о конкретном формате, но он должен быть один на весь проект. - Тест по спецификации, а не по реализации. Ожидаемое значение — это конкретное число из требований: «500», а не «total * 0.05». Тест не должен знать, как устроен код. Он должен знать, что код обязан сделать.
- Изоляция. Unit-тест не ходит в базу, сеть и файловую систему. Внешние зависимости подменяются. При этом мокаются именно внешние зависимости, а не всё подряд.
- Детерминизм. Тест даёт одинаковый результат при каждом запуске: никаких
DateTime.Now,Guid.NewGuid()и случайных чисел без контроля. - Граничные значения. Если в требованиях есть порог, тест проверяет значение до порога, на пороге и после. Именно на границах живёт большинство ошибок.
Анатомия промпта для тестов
Хороший промпт для генерации тестов состоит из нескольких блоков. Каждый из них закрывает конкретный пробел в знаниях агента.
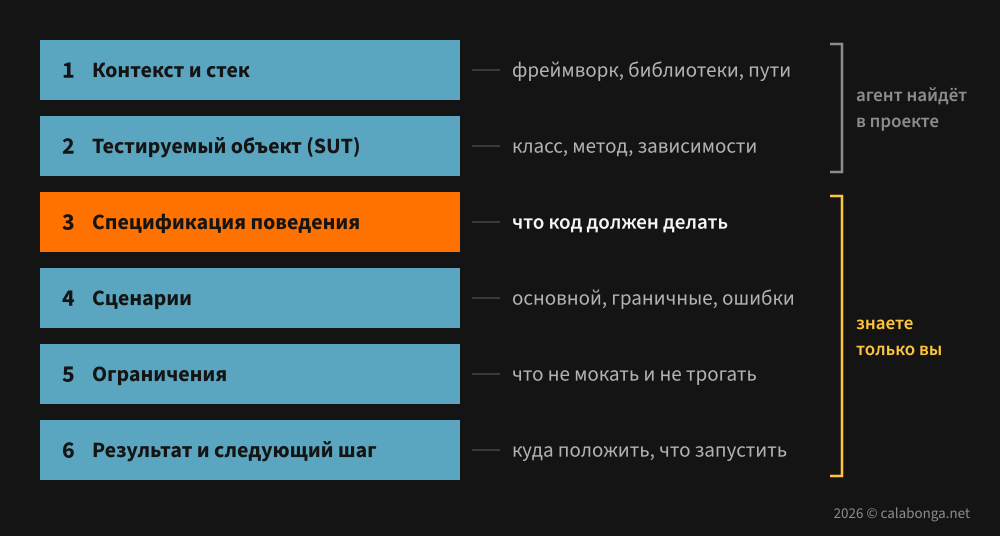
Блоки промпта: что агент узнаёт из каждого из них
- Контекст и стек. Тестовый фреймворк, библиотеки, расположение тестового проекта. Без этого агент выберет то, что встречал чаще всего, например FluentAssertions и NSubstitute, а у вас Moq и AutoFixture.
- Тестируемый объект (system under test, SUT). Какой класс и какой метод тестируем, где он лежит, какие у него зависимости.
- Спецификация поведения. Самый важный блок. Что метод должен делать, сформулированное как требования, а не как пересказ кода.
- Сценарии. Основной сценарий (happy path), граничные случаи (edge cases), ошибки и исключения. Граничные значения лучше перечислить явно.
- Ограничения. Что не мокать, что не тестировать, чего не делать.
- Формат результата и следующий шаг. Куда положить файл, что сделать после генерации, например запустить тесты.
Вот как выглядит промпт для нашего OrderService, если собрать все блоки вместе:
Напиши unit-тесты для OrderService.PlaceOrderAsync
(src/Shop.Application/Orders/OrderService.cs).

Спецификация (тесты пишем по ней, а не по коду):
- пустой заказ → Operation с Ok == false и Error == "Пустой заказ",  в репозиторий ничего не добавляется;
- сумма заказа меньше 10 000 → скидки нет;
- сумма от 10 000 → скидка 5% от суммы;
- сумма от 50 000 → скидка 10% от суммы;
- корректный заказ добавляется в репозиторий (InsertAsync) ровно один раз;
- CancellationToken передаётся в InsertAsync без изменений;
- сохранение не удалось (IUnitOfWork.Result.Ok == false) → Operation с Ok == false и Error == "Не удалось сохранить заказ".

Обязательно проверь граничные значения: 9 999, 10 000, 49 999, 50 000.
Ожидаемые значения скидки указывай числами, не вычисляй их формулой.
Order и OrderItem не мокай — создавай настоящие объекты.

Файл: tests/Shop.Application.UnitTests/Orders/OrderServiceTests.cs.
Конвенции — раздел «Тестирование» в CLAUDE.md.
После генерации запусти dotnet test и покажи результат.
Обратите внимание: в промпте нет ни слова про AAA, именование и AutoFixture. Всё это общие правила проекта, и в каждом промпте им не место. Они живут в файле инструкций, о котором пойдёт речь в следующем разделе. В промпте остаётся только то, что относится к конкретной задаче: объект, спецификация, границы.
Постоянные инструкции агента
Если каждый раз писать в промпте «используй xUnit, Moq и AutoFixture, называй тесты так-то, не мокай сущности», через неделю вы начнёте это пропускать. Агент тут же вернётся к своим привычкам по умолчанию. Правила, общие для всего проекта, нужно записать один раз в файл, который агент читает автоматически.
В Claude Code это файл CLAUDE.md в корне репозитория. У других агентов есть свои аналоги:
| Агент | Файл инструкций |
|---|---|
| Claude Code | CLAUDE.md |
| GitHub Copilot | .github/copilot-instructions.md |
| Cursor | .cursor/rules/*.mdc |
| Codex и другие | AGENTS.md |
AGENTS.md постепенно становится общим стандартом. Если в команде используют разных агентов, удобно держать правила в нём, а в CLAUDE.md просто подключить его строкой @AGENTS.md: Claude Code поддерживает импорт файлов через @.
Раздел «Тестирование» в CLAUDE.md
Вот пример раздела, который закрывает большую часть типовых проблем:
## Тестирование

### Стек
- xUnit, Moq, AutoFixture (+ AutoFixture.AutoMoq, AutoFixture.Xunit2)
- Проверки — стандартный Assert из xUnit, без сторонних assertion-библиотек
- Результаты операций — Operation<T, TError> из Calabonga.Results
  (namespace Calabonga.OperationResults)
- Доступ к данным — IUnitOfWork и IRepository<T> из Calabonga.UnitOfWork

### Структура
- Тесты лежат в tests/<Проект>.UnitTests и повторяют структуру папок src
- Один тестовый класс на один тестируемый класс: OrderService → OrderServiceTests

### Правила
- Имя теста: Метод_Условие_ОжидаемыйРезультат
- Тело теста разделено комментариями // Arrange, // Act, // Assert
- SUT и его зависимости создаёт AutoFixture через [AutoMoqData];
  мок, который нужно настроить или проверить, получаем через [Frozen] Mock<T>
- Для сервисов на IUnitOfWork используем UnitOfWorkCustomization<TEntity>
  и атрибуты на её основе (например, [OrderAutoData] для Order).
  GetRepository<T>() и Result вручную в тестах не настраиваем
- IUnitOfWork.SaveChangesAsync() не бросает исключений: ошибку сохранения
  моделируем через IUnitOfWork.Result с заполненным Exception
- Мокаем только внешние зависимости: IUnitOfWork, IRepository<T>, HTTP-клиенты,
  шину сообщений. Доменные сущности и value objects создаём настоящие
- Однотипные сценарии с разными входными данными — [Theory] + [InlineAutoMoqData]
  (или [InlineOrderAutoData] и аналоги)
- Значения decimal в атрибутах передаём как int или double и приводим в тесте
- Ожидаемые значения — литералы из требований, не формулы из кода
- Для Operation всегда сначала проверяем Ok, затем Result или Error.
  Assert.NotNull для Operation не используем: это структура
- Verify используем только тогда, когда вызов зависимости и есть ожидаемое поведение
- Время — только через TimeProvider, в тестах — FakeTimeProvider
- Приватные методы напрямую не тестируем

### Если тест падает
- НЕ меняй ожидаемое значение, чтобы тест прошёл
- Сначала сообщи: какой тест упал, что ожидалось, что получено
  и в чём, по-твоему, ошибка — в тесте или в коде
Атрибуты AutoFixture
Правила ссылаются на атрибуты [AutoMoqData] и [InlineAutoMoqData]. Их стоит один раз добавить в тестовый проект, чтобы агент не изобретал их заново в каждом файле:
public sealed class AutoMoqDataAttribute() : AutoDataAttribute(
    () => new Fixture().Customize(new AutoMoqCustomization()));

public sealed class InlineAutoMoqDataAttribute(params object[] values)
    : InlineAutoDataAttribute(new AutoMoqDataAttribute(), values);
AutoMoqCustomization заставляет AutoFixture подставлять моки Moq вместо интерфейсов. Поэтому SUT можно просто принять параметром теста, и конструктор со всеми зависимостями соберётся сам. Шаблонного кода с new Mock<...>() и ручным вызовом конструктора становится заметно меньше.
Кастомизация для Calabonga.UnitOfWork
С IUnitOfWork одних атрибутов мало. Сервис вызывает GetRepository<Order>() и читает Result, а пустой мок вернёт там null. Если ничего не сделать, агент в каждом тесте будет заново писать те четыре строки настройки, которые вы видели в «плохом» тесте. Правильнее один раз оформить это как кастомизацию (customization) AutoFixture:
public sealed class UnitOfWorkCustomization<TEntity> : ICustomization
    where TEntity : class
{
    public void Customize(IFixture fixture)
    {
        var repository = fixture.Freeze<Mock<IRepository<TEntity>>>();
        var unitOfWork = fixture.Freeze<Mock<IUnitOfWork>>();

        unitOfWork
            .Setup(x => x.GetRepository<TEntity>(It.IsAny<bool>()))
            .Returns(repository.Object);

        // по умолчанию сохранение проходит успешно
        unitOfWork
            .Setup(x => x.Result)
            .Returns(new SaveChangesResult());
    }
}

public sealed class OrderAutoDataAttribute() : AutoDataAttribute(
    () => new Fixture()
        .Customize(new AutoMoqCustomization())
        .Customize(new UnitOfWorkCustomization<Order>()));

public sealed class InlineOrderAutoDataAttribute(params object[] values)
    : InlineAutoDataAttribute(new OrderAutoDataAttribute(), values);
Моки IUnitOfWork и IRepository<Order> здесь «заморожены» (frozen). Поэтому тест, который принимает [Frozen] Mock<IRepository<Order>> или [Frozen] Mock<IUnitOfWork>, получает те же самые экземпляры, что и OrderService.
Обратите внимание: это знание о вашей инфраструктуре, а не об xUnit или Moq. Агент не может его угадать, зато может прочитать в CLAUDE.md. Именно поэтому в разделе «Тестирование» есть отдельные строки про UnitOfWorkCustomization и про то, что SaveChangesAsync() не бросает исключений.
Разрешения на запуск
Чтобы агент мог сам запускать сборку и тесты, не спрашивая каждый раз подтверждения, добавьте разрешения в .claude/settings.json:
{
  "permissions": {
    "allow": [
      "Bash(dotnet build:*)",
      "Bash(dotnet test:*)"
    ]
  }
}
Процесс как skill
Когда процесс устоится, его можно оформить как skill: файл .claude/skills/unit-tests/SKILL.md. Он вызывается командой /unit-tests и описывает не правила оформления (они уже есть в CLAUDE.md), а порядок работы:
---
name: unit-tests
description: Генерация unit-тестов для указанного класса по спецификации.
  Используй, когда просят написать или дополнить unit-тесты.
---

Тестируемый объект: $ARGUMENTS

1. Прочитай класс и его зависимости.
2. Если спецификация поведения не передана — спроси её. Не выводи требования из кода.
3. Составь таблицу сценариев: условие → ожидаемый результат.
   Отдельно перечисли граничные значения. Покажи таблицу и дождись подтверждения.
4. Сгенерируй тесты по утверждённой таблице, соблюдая раздел «Тестирование» в CLAUDE.md.
5. Запусти dotnet test. При падениях действуй по правилу «Если тест падает».
6. Выведи итог: сколько тестов, какие сценарии покрыты, что не покрыто.
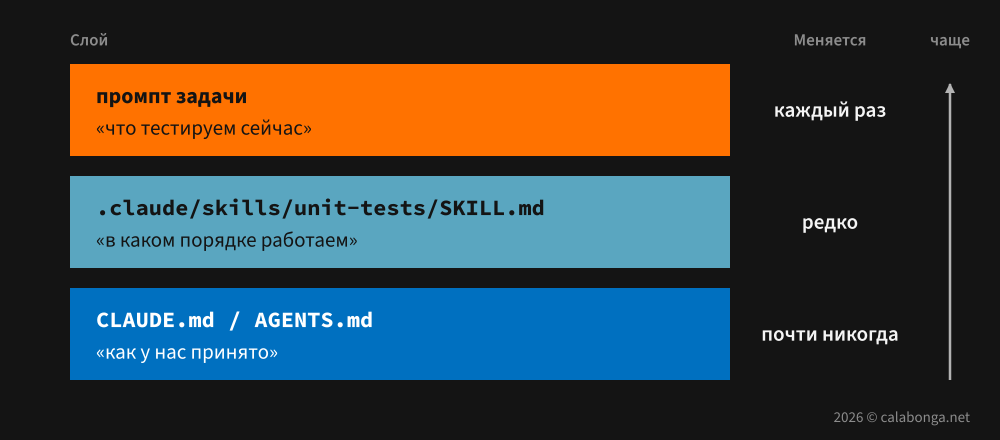
Три слоя: правила проекта, процесс и конкретная задача
В итоге получается три слоя. CLAUDE.md отвечает на вопрос «как у нас принято». Skill отвечает на вопрос «в каком порядке работаем». Промпт отвечает на вопрос «что тестируем сейчас». Каждый слой меняется со своей скоростью, и ни один не дублирует другой.
Сначала сценарии, потом код
Самый полезный приём из всей статьи — разделить генерацию тестов на два шага. Вы уже видели его в skill выше, теперь разберём, почему он работает.
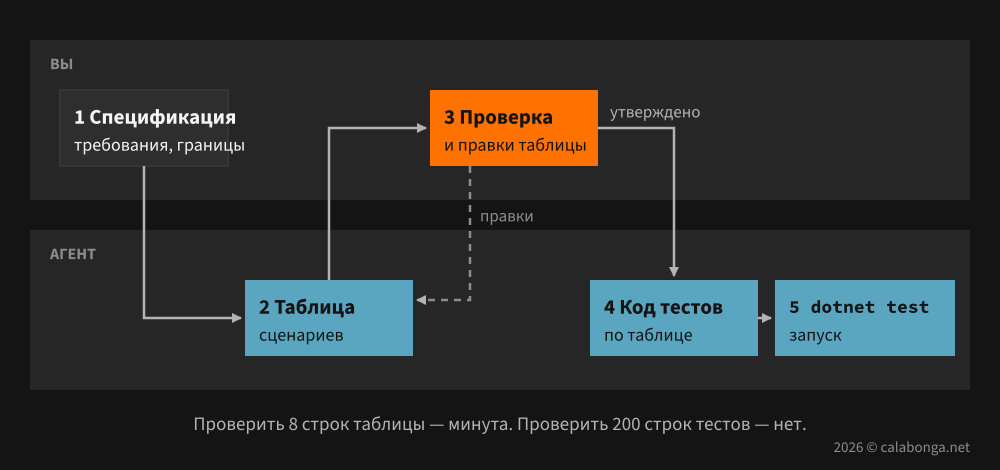
Человек проверяет сценарии, а не код тестов
Шаг первый: агент выдаёт таблицу сценариев. Не код, а список «условие → ожидаемый результат»:
| № | Условие | Ожидаемый результат |
|---|---|---|
| 1 | Заказ без позиций | Ошибка «Пустой заказ», InsertAsync не вызван |
| 2 | Сумма 9 999 | Скидка 0 |
| 3 | Сумма 10 000 | Скидка 500 |
| 4 | Сумма 49 999 | Скидка 2 499,95 |
| 5 | Сумма 50 000 | Скидка 5 000 |
| 6 | Корректный заказ | InsertAsync вызван один раз с этим заказом |
| 7 | Передан CancellationToken |
Тот же токен передан в InsertAsync |
| 8 | IUnitOfWork.Result.Ok == false |
Ошибка «Не удалось сохранить заказ» |
Шаг второй: вы правите таблицу, и только потом агент пишет код.
Почему это работает? Проверить таблицу из восьми строк можно за минуту, а проверить тридцать тестов на двести строк — нет. На этапе таблицы сразу видно, что агент забыл границу 49 999 или решил, что скидки суммируются. Ошибка в понимании требований исправляется до того, как она превратилась в код.
Второй, менее очевидный эффект: таблица отвязывает тесты от реализации. Когда агент сначала формулирует ожидания словами и числами, а потом пишет код, ему гораздо сложнее скатиться в «вычислю ожидаемое значение той же формулой». Ожидаемые значения уже зафиксированы в таблице.
По этой таблице агент генерирует, например, такие тесты:
public class OrderServiceTests
{
    [Theory, OrderAutoData]
    public async Task PlaceOrderAsync_EmptyOrder_ReturnsFailureAndDoesNotInsert(
        [Frozen] Mock<IRepository<Order>> repository,
        OrderService sut)
    {
        // Arrange
        var order = new Order([]);

        // Act
        var result = await sut.PlaceOrderAsync(order, CancellationToken.None);

        // Assert
        Assert.False(result.Ok);
        Assert.Equal("Пустой заказ", result.Error);
        repository.Verify(
            x => x.InsertAsync(It.IsAny<Order>(), It.IsAny<CancellationToken>()),
            Times.Never);
    }

    [Theory, OrderAutoData]
    public async Task PlaceOrderAsync_SaveFailed_ReturnsFailure(
        [Frozen] Mock<IUnitOfWork> unitOfWork,
        OrderService sut)
    {
        // Arrange
        var order = new Order([new OrderItem("SKU-1", price: 1_000m, quantity: 1)]);
        unitOfWork
            .Setup(x => x.Result)
            .Returns(new SaveChangesResult { Exception = new InvalidOperationException() });

        // Act
        var result = await sut.PlaceOrderAsync(order, CancellationToken.None);

        // Assert
        Assert.False(result.Ok);
        Assert.Equal("Не удалось сохранить заказ", result.Error);
    }

    [Theory]
    [InlineOrderAutoData(9_999, 0)]
    [InlineOrderAutoData(10_000, 500)]
    [InlineOrderAutoData(49_999, 2_499.95)]
    [InlineOrderAutoData(50_000, 5_000)]
    public async Task PlaceOrderAsync_TotalAtThreshold_AppliesExpectedDiscount(
        int total,
        double expectedDiscount,
        OrderService sut)
    {
        // Arrange
        var order = new Order([new OrderItem("SKU-1", price: total, quantity: 1)]);

        // Act
        var result = await sut.PlaceOrderAsync(order, CancellationToken.None);

        // Assert
        Assert.True(result.Ok);
        Assert.Equal((decimal)expectedDiscount, result.Result.Discount);
    }
}
Сравните с тестом из раздела «Почему «напиши тесты» не работает». Ожидаемые значения — литералы. Границы перечислены явно. По имени теста понятно, что сломалось. Ветка с ошибкой сохранения теперь проверена отдельным тестом. Ни в одном тесте нет ручной настройки GetRepository<Order>(): это сделала кастомизация. А в тесте скидки моки не упоминаются вовсе, потому что проверять их в этом сценарии незачем.
Небольшое техническое замечание. Тип
decimalнельзя передать в атрибут C#, поэтому значения приходят какintиdoubleи приводятся внутри теста. Это правило уже записано вCLAUDE.md, иначе агент будет каждый раз заново натыкаться на ошибку компиляции.
Цикл «сгенерировал → запустил → исправил»
Агент, который умеет запускать dotnet test, гораздо полезнее агента, который только пишет код. Он сам видит ошибки компиляции, падения и исправляет их, пока всё не соберётся и не позеленеет. Разрешения на запуск мы уже дали в разделе «Постоянные инструкции агента».
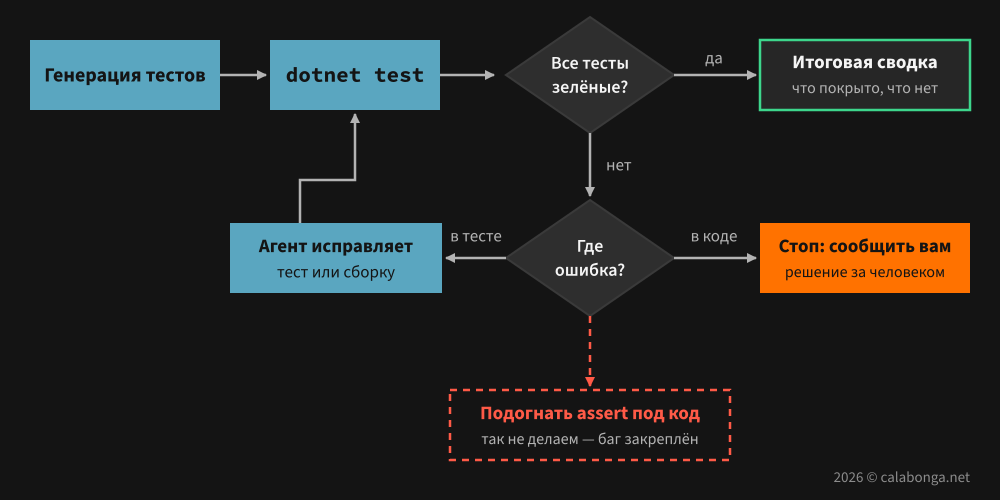
Падение теста — повод остановиться и спросить, а не подогнать assert
Но в этом цикле есть ловушка, и о ней обязательно нужно знать. Цель агента в цикле — «чтобы тесты прошли». Если тест упал, у агента есть два способа добиться цели:
- исправить тест, если ошибка в тесте;
- изменить ожидаемое значение, если ошибка в коде.
Второй вариант выглядит как исправление, но на деле закрепляет баг. Представьте, что в сервисе вместо >= 10_000m написано > 10_000m. Тест для суммы 10 000 ожидает скидку 500 и падает. Агент видит, что код вернул 0, «исправляет» ожидание на 0 и рапортует: все тесты зелёные. Тест, который должен был поймать ошибку, теперь её охраняет.
Именно для этого в разделе «Тестирование» есть правило «Если тест падает». Агент не меняет ожидаемое значение молча. Он сообщает, что упало, что ожидалось и что получено, и высказывает предположение, где ошибка. Решение принимаете вы. Так падающий тест превращается из досадной помехи в то, ради чего тесты и пишутся: в найденный дефект.
Пара практических советов для этого цикла:
- Ограничьте область запуска.
dotnet test --filter "FullyQualifiedName~OrderServiceTests"работает быстрее полного прогона и не засоряет контекст агента чужими падениями. - Просите итоговую сводку. Сколько тестов добавлено, какие сценарии из таблицы покрыты, какие нет. Отсутствующий сценарий из сводки заметить проще, чем из кода.
Типичные ошибки агента
Даже с хорошими инструкциями агент время от времени возвращается к своим привычкам по умолчанию. Вот ошибки, которые встречаются чаще всего, и как их предупредить.
Избыточные моки. Агент мокает всё, что видит: сущности, value objects, иногда даже тестируемый класс. Тест превращается в проверку того, что моки возвращают то, что им сказали вернуть. Решение — явное правило «мокаем только внешние зависимости» и перечень того, что считается внешней зависимостью в вашем проекте.
Проверка вызовов вместо результата. Verify на каждый вызов каждой зависимости. Такой тест проверяет не поведение, а реализацию, и ломается при любом рефакторинге. Проверка взаимодействия (interaction testing) уместна, когда вызов и есть результат: «заказ сохранён», «заказ не сохранён», «сообщение отправлено в шину». Во всех остальных случаях проверяем состояние (state testing), то есть возвращённый результат.
Недетерминизм. Если код использует DateTime.Now, тест будет зависеть от времени запуска. Лечится это на стороне кода, а не теста: время внедряется через TimeProvider, а в тестах используется FakeTimeProvider из пакета Microsoft.Extensions.TimeProvider.Testing:
var timeProvider = new FakeTimeProvider(new DateTimeOffset(2026, 11, 27, 10, 0, 0, TimeSpan.Zero));
fixture.Inject<TimeProvider>(timeProvider);
Если агент видит в коде DateTime.Now, пусть сообщит об этом, а не пытается обойти проблему в тесте.
Копипаста вместо параметризации. Пять одинаковых [Fact], которые различаются одной цифрой. Правило про [Theory] + [InlineAutoMoqData] в CLAUDE.md решает это почти полностью.
Тесты на фреймворк. «Проверим, что AutoFixture создал объект» или «что List.Add добавил элемент». Такие тесты проверяют не ваш код, а чужой, который уже протестирован. Достаточно строки в инструкциях: «Не тестируй поведение фреймворков и библиотек».
Тестирование приватных методов через рефлексию. Если агенту кажется, что без этого никак, это сигнал о проблеме дизайна, а не о том, что нужна рефлексия. Правило «приватные методы напрямую не тестируем» плюс просьба сообщать о таких случаях.
Как проверить, что тесты действительно тестируют
Тесты сгенерированы, всё зелёное. Как понять, что они чего-то стоят?
Покрытие кода
Первое, что приходит в голову, — покрытие кода (code coverage). Собирается оно стандартно, через coverlet:
dotnet test --collect:"XPlat Code Coverage"
Покрытие полезно, чтобы найти непокрытый код. Но о качестве покрытого кода оно не говорит ничего. Тест из раздела «Почему «напиши тесты» не работает» даёт почти 100% покрытия метода PlaceOrderAsync, при этом не ловит ни одной реальной ошибки. Строка выполнена — это не то же самое, что строка проверена.
Мутационное тестирование
Гораздо честнее мутационное тестирование (mutation testing). Идея простая. Инструмент вносит в код маленькие изменения, мутанты: меняет >= на >, + на -, удаляет вызов метода. После каждого изменения он прогоняет тесты. Если тесты упали, мутант «убит», и это хорошо. Если тесты остались зелёными, мутант «выжил», а значит, такую ошибку тесты не заметили бы.
Для .NET есть Stryker.NET:
dotnet tool install -g dotnet-stryker
cd tests/Shop.Application.UnitTests
dotnet stryker
Для нашего примера всё наглядно. Stryker заменит >= 10_000m на > 10_000m. Набор тестов без граничного значения 10 000 этого не заметит, и мутант выживет. Набор с [InlineOrderAutoData(10_000, 500)] его убьёт. Это та же ошибка, которую мы разбирали в разделе «Цикл «сгенерировал → запустил → исправил»», только теперь её находит инструмент, а не случай.
Выжившие мутанты — отличный материал для следующего промпта. Отчёт Stryker можно отдать агенту с просьбой: «Вот выжившие мутанты. Для каждого предложи сценарий, который бы его убил, в виде строки таблицы сценариев». И мы снова возвращаемся к подходу из раздела «Сначала сценарии, потом код».
Чек-лист ревью сгенерированных тестов
Перед тем как принять тесты от агента, пройдитесь по короткому списку:
- Ожидаемые значения — литералы, а не формулы из кода
- Каждый порог из требований проверен до, на и после границы
- Имя каждого теста описывает сценарий и ожидаемый результат
- Моки только для внешних зависимостей
-
Verifyтолько там, где вызов и есть проверяемое поведение - Нет
DateTime.Now,Guid.NewGuid()и случайных данных без контроля - Однотипные сценарии объединены в
[Theory] - Ни одно ожидаемое значение не было изменено, чтобы тест прошёл
Заключение
ИИ-агент — отличный инструмент для написания тестов, но только если он знает то, что знаете вы: требования, конвенции проекта и что считается хорошим тестом. Код агент прочитает сам, а вот спецификацию из кода не вывести. Если её не дать, тесты повторят реализацию вместе со всеми её ошибками.
Коротко о том, что стоит сделать:
- Записать правила тестирования один раз — в
CLAUDE.mdилиAGENTS.md. - Добавить в тестовый проект атрибуты
[AutoMoqData]и[InlineAutoMoqData], а для сервисов наIUnitOfWork— кастомизациюUnitOfWorkCustomization<TEntity>. - Разрешить агенту запуск
dotnet buildиdotnet test. - В промпте передавать спецификацию и граничные значения, а не просто имя класса.
- Сначала утверждать таблицу сценариев, потом генерировать код.
- Запретить агенту менять ожидаемые значения без вашего решения.
- Проверять результат мутационным тестированием, а не только покрытием.
И итоговый шаблон промпта, который можно взять как отправную точку:
Напиши unit-тесты для <Класс>.<Метод> (<путь к файлу>).

Спецификация (тесты пишем по ней, а не по коду):
- <условие> → <ожидаемый результат>;
- ...

Граничные значения: <список>.
Сначала покажи таблицу сценариев и дождись подтверждения.
Конвенции — раздел «Тестирование» в CLAUDE.md.
Всё остальное агент возьмёт из инструкций. А вам останется самое важное: решать, что должен делать код. Эту часть работы за вас не сделает ни один агент.
Использованные сборки
| Сборка | Версия | Назначение |
|---|---|---|
| Calabonga.Results | 2.0.1 | Результат операции Operation<T, TError> (Result Pattern) |
| Calabonga.UnitOfWork | 10.0.3 | Unit of Work и репозитории для EntityFrameworkCore |
| xunit | 2.9.3 | Тестовый фреймворк |
| Moq | 4.21.0 | Моки внешних зависимостей |
| AutoFixture | 4.18.1 | Генерация тестовых данных и SUT |
| AutoFixture.AutoMoq | 4.18.1 | Автоматическая подстановка моков Moq |
| AutoFixture.Xunit2 | 4.18.1 | Атрибуты [AutoData] и [InlineAutoData] для xUnit |
| Microsoft.Extensions.TimeProvider.Testing | 10.10.0 | FakeTimeProvider для детерминированного времени |
| coverlet.collector | 10.1.0 | Сбор покрытия кода |
| dotnet-stryker | 5.0.0 | Мутационное тестирование (глобальный инструмент) |